Redpill Linpro Blogs
Skapa en autonom CRM-incidentutredare med Nova
Inledning
Jag har ägnat en betydande del av min karriär åt att arbeta nära CRM-data. Och om det finns en sak som aldrig slutade vara frustrerande, så är det här: i samma stund som ett larm går av och berättar att en leadkälla har minskat, vet du redan att det svåra inte är upptäckten. Det svåra är allt som kommer efteråt.
I den här artikeln ville jag titta närmare på detta.
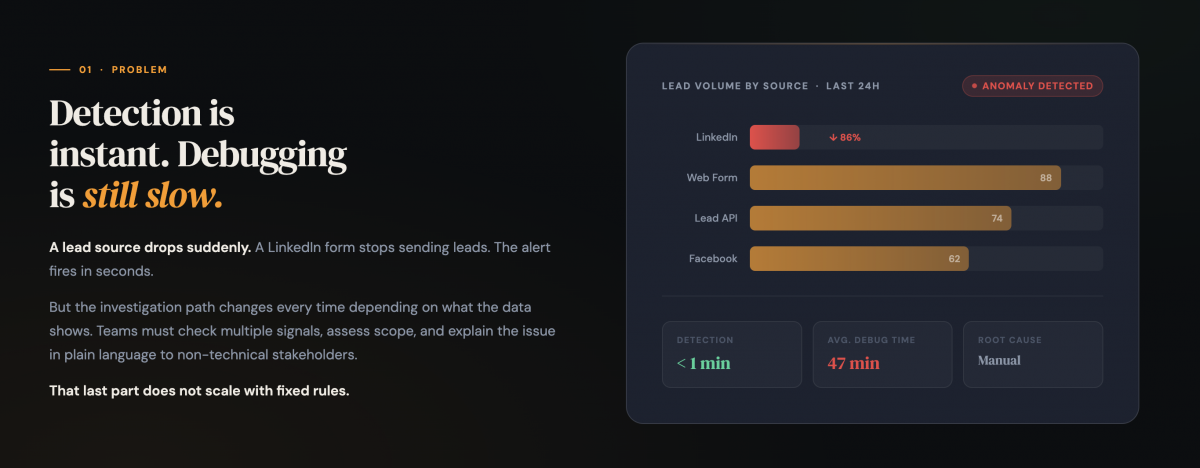
Problemet
Mönstret var alltid detsamma: Leads från källan X i Tyskland rasar över natten. Larmet utlöses. Du öppnar din SQL-klient, börjar formulera hypoteser och kör den första frågan. Resultatet ändrar nästa hypotes. Du kör en fråga till. Sedan ytterligare en. Är nedgången isolerad till Tyskland, eller slår den mot samma källa även på andra marknader? Stannade pipelinen vid en specifik tidpunkt, eller skedde det gradvis? Är det ett formulärproblem eller något i den bredare källfamiljen?
Varje incident såg likadan ut på ytan. Undersökningen under ytan var alltid annorlunda. Man kunde inte skriva en fast regel som täckte alla, eftersom rätt väg helt berodde på vad datan visade.
Och när du väl hade ditt svar behövde du förklara det. Verksamheten, säljavdelningen, ledningen. De behövde agera utifrån det, vilket innebar att du behövde översätta frågeresultat till klarspråk som var korrekt, tydligt och snabbt. Den översättningen gjordes varje gång. Den var repetitiv, tidskrävande, och det fanns inget sätt att generalisera den med regler.
Jag började tänka på det här projektet inte som ett hackathonbidrag utan som en lösning på något som på allvar hade oroat mig i flera år.
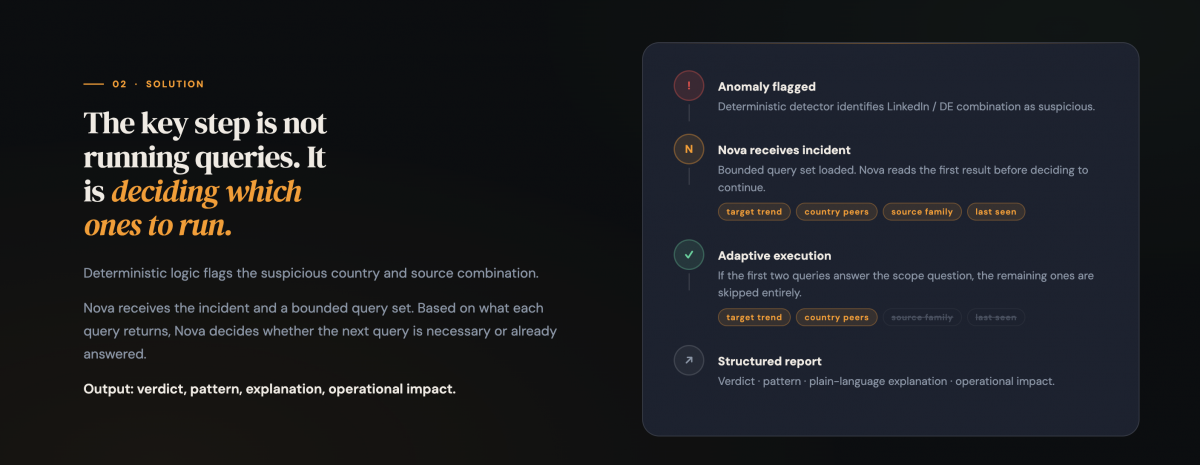
Lösningen
Den autonoma CRM Incident Investigator är ett agentbaserat system byggt på Amazon Nova Pro V1 via Amazon Bedrock, där Amazon Athena sköter frågekörningen.
Detektionssteget är rakt igenom SQL. En förberedande fråga jämför de senaste 28 dagarnas CRM-data med de senaste 7 dagarna och flaggar varje kombination av källa och land där volymen minskat med mer än 50 %. Den delen kräver ingen språkmodell.
Det som händer sedan gör det. Varje flaggad anomali skickas till Nova Pro V1 tillsammans med en begränsad uppsättning förregistrerade Athena Named Queries. Nyckelordet är begränsad. Nova får inte tillgång till godtycklig SQL. Den får tillgång till exakt de frågor som är viktiga för just denna typ av incident: dag-för-dag-trenden för volymen, volymerna för jämförbara länder, källfamiljens motsvarigheter i andra länder, tidsstämpeln för senast sedda post samt ett stickprov på radnivå för slutlig granskning.
Nova läser resultatet av varje fråga innan den bestämmer sig för om nästa ska köras. Om de två första frågorna visar att minskningen gäller hela landet tillför källfamiljefrågan ingenting. Nova hoppar över den. Om evidensen pekar någon oväntad väg fortsätter den. Vägen formas av datan, inte av hårdkodad förgreningslogik som en människa i förväg skrivit och som inte kan förutse alla scenarier.
Sessionsminnet bär med sig fynd mellan iterationerna av anomalier inom samma detektionscykel. Om Nova bekräftar en svaghet i flera länder för den första flaggade källan hoppar efterföljande undersökningar för samma källfamilj helt över jämförelseanalysen. Systemet upprepar inte arbete som redan är gjort.
Resultatet är ett strikt typat JSON-utlåtande: grundorsak, mönsterklassificering, förklaring i klartext och operativ påverkan. Redo att överlämnas till vem som helst, teknisk eller ej.
Demo
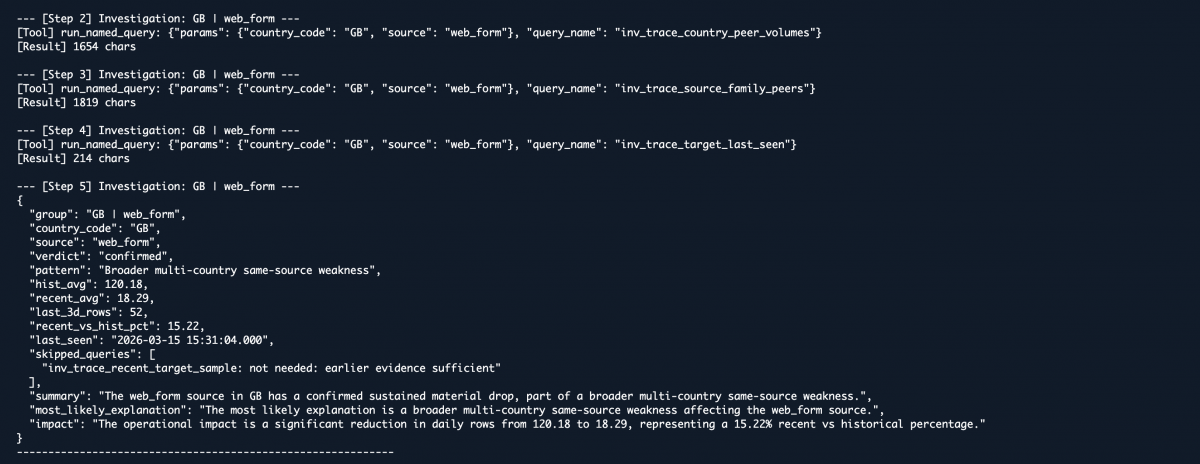
Demot körs mot ett syntetiskt dataset med 500 000 CRM-leadposter som spänner över fem månader, med två avsiktliga anomalier införda under den sista veckan. Den första är isolerad: FR | LinkedinForm går över natten till noll. Den andra är bredare: GB | web_form och DE | web_form minskar båda med 85 %, vilket representerar ett fel i en källfamilj som omfattar flera länder.
För den franska anomalin kör Nova hela kedjan. Den spårar trenden, kontrollerar jämförbara källor inom Frankrike, undersöker källfamiljen på andra marknader och hämtar den exakta tidpunkt då pipelinen stannade.
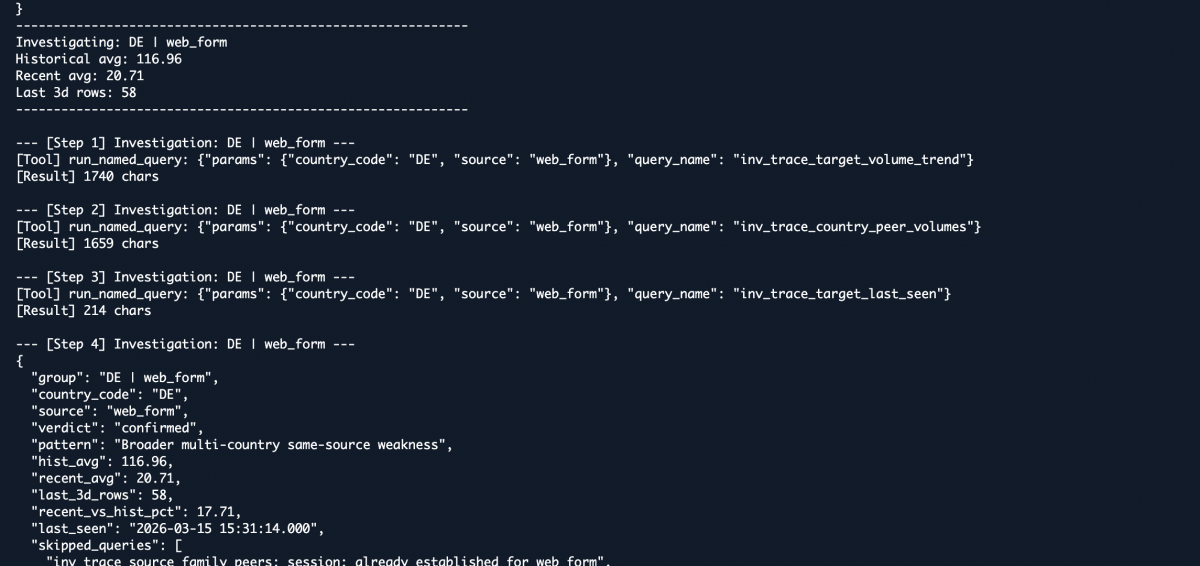
För den tyska anomalin, som följer i samma detektionscykel, identifierar Nova tidigt att nedgångsmönstret överensstämmer med den flerlandssvaghet som redan fastställts för GB | web_form. Källfamiljefrågan hoppas över.
Färre steg, samma kvalitet på slutsatsen.
Det är vad demot är utformat för att visa. Inte att systemet kan anropa en fråga. Utan att det kan sluta anropa en när bevisen redan besvarar nästa fråga.
Demolänk: https://www.youtube.com/watch?v=jmkgq3DpeTc
Vad detta kan innebära för CRM-team?
Den mest uppenbara fördelen är tid. Genomsnittlig tid till lösning för denna typ av incident sjunker från timmar till minuter, utan att en dataanalytiker behöver vara tillgänglig och byta fokus varje gång en avisering utlöses.
Men den mindre uppenbara fördelen är konsekvens. När en människa undersöker manuellt beror kvaliteten på resultatet på vem som gör det, hur mycket tid hen har och hur väl hen känner till just den typen av avvikelse. Ett autonomt system producerar samma strukturerade resultat varje gång, oavsett volym av incidenter eller tid på dygnet.
Arkitekturen är inte begränsad till övervakning av lead-källor. Alla CRM-dataincidenter där hypotesrymden kan definieras i förväg är kandidater: avvikelser i konverteringsgrad, toppar i dubblettposter, datakvalitetsfel på fältnivå. Det är lagret för verktygsregistrering som förändras. Agentlogiken förblir densamma.
Nästa steg är att koppla detekteringslagret till ett befintligt larmsystem så att utredaren startar automatiskt i stället för på begäran. Det sluter loopen helt och förvandlar det som i dagsläget är ett verktyg man kör till ett system som går av sig självt.
Källkoden är offentlig. Stacken består av Python, Boto3 och aktiva AWS-autentiseringsuppgifter med åtkomst till Bedrock och Athena. Om du redan använder AWS tar installationen under trettio minuter.
Github-länk: https://github.com/selimsevim/nova-crm-investigator